La cause n°1 d’abandon d’une supervision Zabbix n’est pas technique — c’est humaine. Une équipe submergée d’alertes finit par toutes les ignorer, y compris la seule qui comptait vraiment. Voici les réglages qui font la différence entre une supervision qu’on écoute et une boîte mail qu’on filtre.
Le problème du seuil simple
Un trigger du type last(/host/cpu.load)>80 semble raisonnable, jusqu’à ce qu’un pic de charge normal de 90 secondes déclenche une alerte, un rappel de résolution, puis une nouvelle alerte dix minutes plus tard. Multiplié par des dizaines d’hôtes, ça devient rapidement ingérable.
Utiliser des fonctions d’agrégation, pas des valeurs instantanées
Plutôt que de réagir à une valeur ponctuelle, on déclenche sur une moyenne glissante :
avg(/host/cpu.load,5m)>80Ce trigger ne se déclenche que si la charge moyenne sur 5 minutes dépasse 80 % — un pic isolé de quelques secondes ne suffit plus à générer une alerte. Le choix de la fenêtre temporelle (5 minutes, 15 minutes, 1 heure) dépend de la métrique : un pic de charge CPU transitoire est normal, une saturation mémoire soutenue ne l’est pas.
Ajouter de l’hystérésis pour éviter le flapping
Le « flapping » — une alerte qui s’active et se désactive en boucle parce que la valeur oscille juste autour du seuil — est une des principales sources de bruit. La solution consiste à utiliser deux seuils différents pour le déclenchement et la résolution :
{TRIGGER.VALUE}=0 and avg(/host/cpu.load,5m)>80
or
{TRIGGER.VALUE}=1 and avg(/host/cpu.load,5m)>65
L’alerte se déclenche au-delà de 80 %, mais ne se résout que lorsque la charge redescend sous 65 %. Cet écart empêche les allers-retours constants autour d’un seuil unique.
Hiérarchiser par sévérité, systématiquement
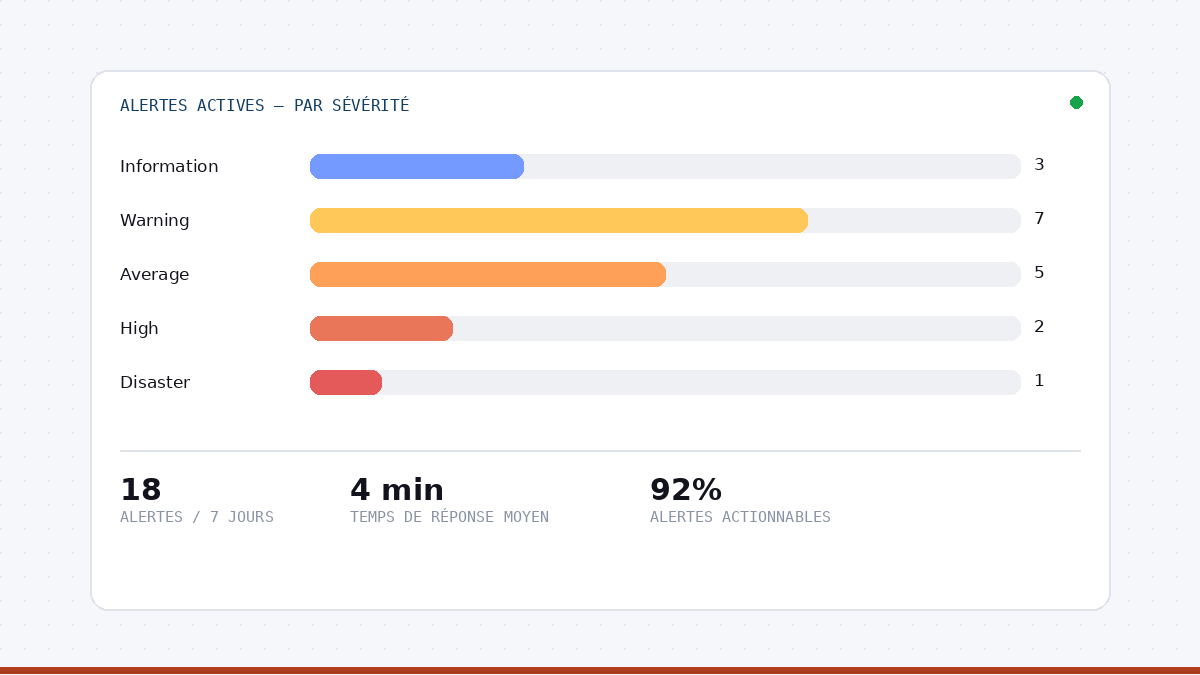
Zabbix propose cinq niveaux de sévérité (Information, Avertissement, Moyenne, Haute, Catastrophique). Le laisser par défaut sur « Non classée » pour tout revient à traiter un disque plein comme un serveur down. Chaque trigger devrait être classé selon son impact réel sur le service, et les canaux de notification (email, SMS, astreinte) devraient être routés différemment selon la sévérité — un email pour une alerte moyenne, un SMS ou un appel pour une alerte catastrophique.
Utiliser les dépendances de triggers
Quand un switch tombe, tous les équipements derrière lui deviennent injoignables — et génèrent chacun leur propre alerte, noyant la vraie cause sous des dizaines de symptômes. Les dépendances de triggers permettent de dire à Zabbix : « si l’alerte du switch est active, n’envoie pas les alertes des équipements qui en dépendent ». Une panne réseau devient une seule alerte claire, pas cinquante.
Gérer le cas nodata()
Un hôte qui ne remonte plus de données n’est pas forcément un hôte éteint volontairement — mais un trigger mal configuré peut aussi rester silencieux si personne n’a prévu ce cas :
nodata(/host/agent.ping,10m)=1Ce trigger détecte l’absence de données pendant 10 minutes, ce qui couvre le cas où l’agent lui-même est down — un scénario souvent oublié qui laisse un hôte totalement invisible sans qu’aucune alerte ne le signale.
Revoir les seuils après la mise en production, pas seulement avant
Aucun seuil n’est parfait dès le premier jour. La bonne pratique consiste à revoir, après deux à quatre semaines de production réelle, la liste des alertes déclenchées : celles qui reviennent trop souvent sans jamais correspondre à un vrai problème doivent être recalibrées ou supprimées. Une supervision qui n’évolue pas se dégrade progressivement en bruit de fond.
Pour aller plus loin : Comprendre l’architecture Zabbix · Zabbix haute disponibilité
Une stack de supervision bien réglée génère peu d’alertes — mais chacune compte. C’est un objectif de configuration, pas un hasard.