Une supervision qui dépend d’un unique point de défaillance est une contradiction en soi : si le serveur Zabbix tombe en panne au même moment qu’un incident sur l’infrastructure surveillée (panne électrique du datacenter, coupure réseau majeure), personne ne reçoit l’alerte au moment où elle compte le plus. Pour une infrastructure critique, la haute disponibilité de la supervision n’est pas un luxe — c’est une exigence de cohérence.
Le cluster Zabbix Server natif
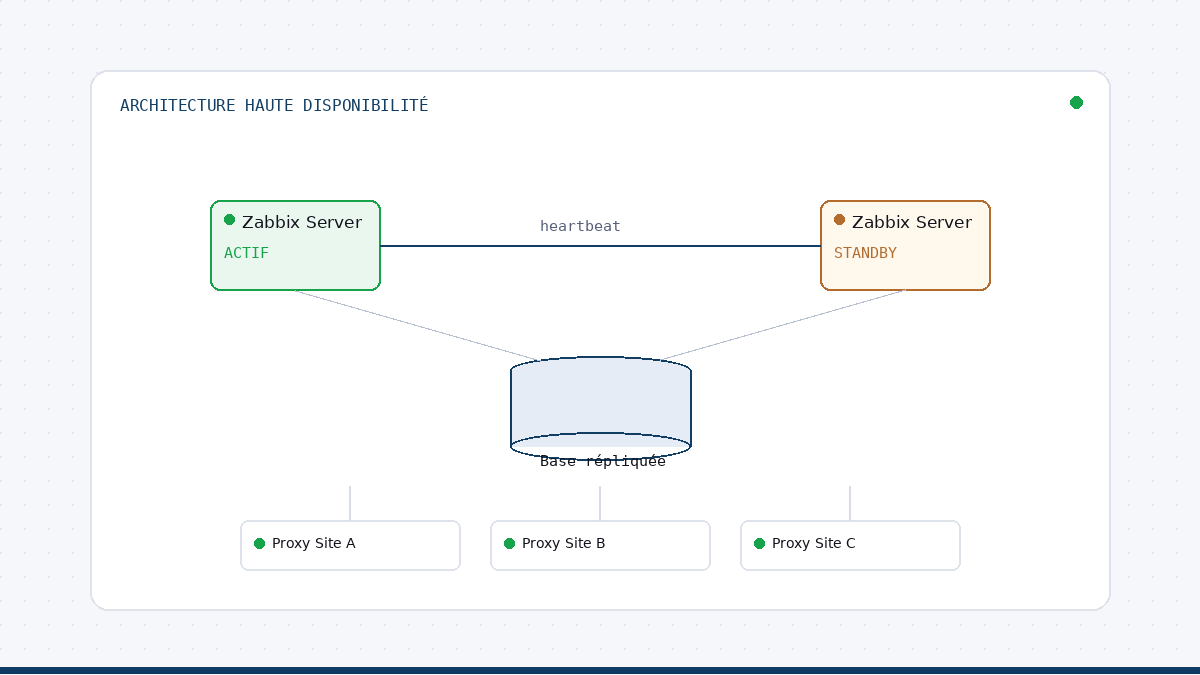
Depuis la version 6.0, Zabbix propose un mécanisme de haute disponibilité natif pour le serveur : plusieurs nœuds serveur peuvent être configurés, avec un mécanisme de heartbeat qui élit un nœud actif et bascule automatiquement vers un nœud de secours en cas de défaillance. Ce mécanisme ne nécessite pas d’outil tiers de clustering (type Pacemaker/Corosync), ce qui simplifie nettement l’exploitation par rapport aux versions antérieures.
La base de données : le vrai point critique
Le cluster de serveurs Zabbix ne sert à rien si la base de données sous-jacente reste un point de défaillance unique. La réplication de base de données (PostgreSQL en streaming replication, ou solutions équivalentes pour MySQL/MariaDB comme Galera Cluster) doit être mise en place en parallèle du cluster applicatif. C’est souvent la partie la plus sous-estimée d’un projet de HA Zabbix — le temps d’intégration y est généralement supérieur à celui du cluster serveur lui-même.
Redondance des proxies sur les sites distants
Sur une architecture multi-sites, chaque proxy représente un point de défaillance local. Pour les sites les plus critiques, déployer deux proxies en parallèle, avec bascule gérée au niveau de la configuration des hôtes ou via un load balancer réseau, évite qu’une panne de proxy isole un site entier de la supervision centrale pendant la durée de résolution.
Le frontend : moins critique, mais pas négligeable
Le frontend web (interface utilisateur) peut être dupliqué derrière un load balancer classique (HAProxy, nginx) sans complexité particulière, puisqu’il est sans état — chaque instance se connecte à la même base de données. C’est la partie la plus simple à rendre hautement disponible, et elle ne doit pas être oubliée simplement parce qu’elle est moins critique que le moteur de traitement.
Un point souvent oublié : les canaux d’alerte eux-mêmes
Une architecture Zabbix parfaitement redondante ne sert à rien si le seul canal de notification configuré (un unique serveur SMTP interne, par exemple) tombe en même temps que l’incident qu’il devrait signaler. Prévoir au moins deux canaux de notification indépendants (email + SMS, ou email + intégration tierce comme PagerDuty ou un webhook vers un système externe) pour les alertes de criticité maximale.
Ce que ça coûte, et ce que ça évite
Une architecture HA complète (cluster serveur, base répliquée, proxies redondants, frontend load-balancé) représente un effort d’intégration significativement supérieur à une installation standard — généralement plusieurs jours d’architecture et de tests en plus. Pour une infrastructure dont l’indisponibilité a un coût direct et mesurable, cet investissement se justifie largement au regard du risque évité.
Pour aller plus loin : Comprendre l’architecture Zabbix · Migrer vers Zabbix sans coupure
La haute disponibilité de la supervision se conçoit dès l’architecture cible, pas en ajout après un incident où elle a manqué.